- Continuous Improvement Culture
- bottleneck
- setup board
- prioritize
- WIP
- preventing workers from becoming overloaded
- Pull
- Metrics & Management Reporting
- Tracking WIP
- Cycle Time
- Due Date Performance
- Throughput
- Issues & Blocked Work Items
- Flow Efficiency
- Initial Quality
- Failure Load
星期四, 11月 20, 2014
Kanban: Successful Evolutionary Change for Technology Organizations

星期日, 8月 31, 2014
Bowling Game Kata
看了Uncle Bob的建議,每天想來練一下Kata
而Uncle Bob又力推Bowling Game,所以原本想拿來當kata練一下不同的語言
沒想到實做之後,才發現這是個滿棒的kata
邏輯不會太難,但可能寫成超複雜的,滿多重構的行為,而且很適合當TDD的教材
把所有的team member都抓來練習一下
以下整理最近帶team member的心得
回想其實好久以前就看過這Bowling Game的練習(很多對話那個)
不過就只有用"看"的,沒有實際寫過,身體力行的體驗果然不一樣
大家也來kata一下
p.s. 不過我以為這保齡球算法的方法大家應該都瞭解
沒想到大家都忘了... 話說上次打應該也是5年前了...
更多的Kata題目
而Uncle Bob又力推Bowling Game,所以原本想拿來當kata練一下不同的語言
沒想到實做之後,才發現這是個滿棒的kata
邏輯不會太難,但可能寫成超複雜的,滿多重構的行為,而且很適合當TDD的教材
把所有的team member都抓來練習一下
以下整理最近帶team member的心得
- Refactoring (clean code)
- 變數、method的命名
刻意讓team member命名滾球、局數
最後讓大家猜別人命名的意思
最後讓大家直接用保齡球的術語roll, frame
clean code: 不懂時,直接請domain expert命名,至少以後domain expert能夠說出這是什麼
- redundant code
去除重覆的程式 - decompose condition
讓程式變的更加clean, isSpare,isStrike,getSpareBonus那段
- 隱藏細節
上一段的延伸,有些team member把整段getSpareBonus做成calSpareBonus
感覺上沒什麼差,但在看code感覺差很多
- calSpareBonus
這個function叫做score(算總分),因此這function最重要的事就是"算分數"
但這裡把算分的邏輯隱藏了,因此未來看code的人,不易注意到score被其他function異動了
int score = 0;//成員變數 - 總分 public int score(){ //略 if (isSpare()) calSpareBonus(); //略 } - getSpareBonus
關於score的異動,能夠清楚掌握
而Spare的Bonus算法在這不重要,因此隱藏起來
讓程式更容易閱讀
public int score(){
    int score = 0;//總分
    //略
    if (isSpare())
        score += getSpareBonus();
    //略
}
- calSpareBonus
- 變數、method的命名
- Pair-Programming
自己開發會有盲點,跟幾個同事練習的過程中
在算跨局的輯邏會想的滿複雜的,但partner會參與討論 也許沒能討論出更好、更簡單的解法,但至少那段神邏輯有另一個人"看的懂"
- TDD
只滿足目前的需求即可
開發上,大家容易被分數算法綁住,因此一開始想把邏輯寫對
但這不太容易,因為算法還得考慮Spare, Strike,因此一次要把邏輯寫出來有點難
寫完,你也不會寫test case了,因為已經寫完繳卷了
這點最適合TDD指的只滿足目前的需求即可
先寫個最簡單的算法驗證,再來spare,再來strike,一個個拼出完整的邏輯
也許整個寫法得翻掉重寫,但令人放心的是test case已經寫好了
所以可以放心重寫
雖然一直說TDD很棒,但沒實際體會過,大家只會覺得很難達成
實際經歷好幾次的大改結構,但重新測試的時間,卻只是一瞬間
大家就能體會TDD好處
回想其實好久以前就看過這Bowling Game的練習(很多對話那個)
不過就只有用"看"的,沒有實際寫過,身體力行的體驗果然不一樣
大家也來kata一下
p.s. 不過我以為這保齡球算法的方法大家應該都瞭解
沒想到大家都忘了... 話說上次打應該也是5年前了...
更多的Kata題目
星期六, 8月 23, 2014
CentOS 7 無法access apache
前陣子聽到CentOS 7出了,載下來裝好發現連不到網頁
搞不清楚問題在哪,最後猜是SELinux~
果然是開啟的
再來就來關掉selinux
改成disabled
再一次
很高興的以為抓到問題,但restart後一樣連不到... QQ
試好久,猜應該是firewall問題
果然一查CentOS 7 firewall,就找到答案了
以下截錄 關閉 CentOS 7 上的 Firewall
總於... 連的到網頁了... ya
搞不清楚問題在哪,最後猜是SELinux~
# sestatus
SELinux status:                 enabled
SELinuxfs mount:                /selinux
Current mode:                   enforcing
Mode from config file:          enforcing
Policy version:                 24
Policy from config file:        targeted
再來就來關掉selinux
改成disabled
# vi /etc/selinux/config
--
# This file controls the state of SELinux on the system.
# SELINUX= can take one of these three values:
#       enforcing - SELinux security policy is enforced.
#       permissive - SELinux prints warnings instead of enforcing.
#       disabled - No SELinux policy is loaded.
SELINUX=disabled
# SELINUXTYPE= can take one of these two values:
#       targeted - Targeted processes are protected,
#       mls - Multi Level Security protection.
SELINUXTYPE=targeted
# sestatus
SELinux status:                 disabled
很高興的以為抓到問題,但restart後一樣連不到... QQ
試好久,猜應該是firewall問題
果然一查CentOS 7 firewall,就找到答案了
以下截錄 關閉 CentOS 7 上的 Firewall
關閉 Firewall
# systemctl stop firewalld

預設不啟動 Firewall
# systemctl disable firewalld
rm '/etc/systemd/system/dbus-org.fedoraproject.FirewallD1.service'
rm '/etc/systemd/system/basic.target.wants/firewalld.service'
總於... 連的到網頁了... ya
星期日, 8月 17, 2014
How to undo the last Git commit?
如何調整已經commit的.... commit
Reference: How to undo the last Git commit?
$ git commit "待調整的commit"   (1)commit後
$ git reset --soft 'HEAD^'       (2)回剛才的commit
$ edit (3)重新調整$ git add .... (4)
$ git commit -c ORIG_HEAD (5)跳視窗修改commit message"待調整的commit"
p.s. 上次回復(revert)到太早期的版本,造成一堆commit都不見
幸好git還是有保留下來,不然就挫咧等...
幸好git還是有保留下來,不然就挫咧等...
星期六, 8月 16, 2014
[書]The Clean Coder
滿精采的一本書,讓開發人員要自我要求,更要表現出專業,勇敢的說Yes/NO
Chapter 1. 專業主義
Chapter 6. 練習
熟能生巧,訓練手指和大腦,每天來一、兩個kata保持技巧純熟
reference: Code Kata
開會的成本很高,有時又是沒有效益的
管理自己的時間是自己的責任
Chapter 1. 專業主義
- Minimal-list
Uncle Bob說軟發開發人員"至少"需"精通"的項目
- Design Patterns
- Design Principles
SOLID - Methods
XP, Scrum, Lean, Kanban, Waterflow,結構化分析及結構化設計等 - Disciplines
TDD, OOD, Continuous Integration, Pair Programming - Artifacts
UML, DFD, 結構圖, Petri網路圖, 狀態圖,流程圖和決策表
能就是能,不能就是不能。不要說「說說看」 --Yoda每次專案一趕,就一定會說的話... (泣)
Chapter 6. 練習
熟能生巧,訓練手指和大腦,每天來一、兩個kata保持技巧純熟
reference: Code Kata
- Bowling Game
- Prime Factors
開會的成本很高,有時又是沒有效益的
管理自己的時間是自己的責任
- 離席
如果發現會議是在浪費時間,應在合適的時機,禮貌地離席
如果已經偏離原有的議程,應要求列新的議題和議程 - 爭論/反對
Kent Beck:凡是不能在5分鐘內解決的爭論,都不能靠辯論解決。」因各方拿不出「足夠有的有的證據」
唯一解決方法是「去取得資料,讓資料來說話」
星期六, 8月 09, 2014
Google表單發確認信

而內含的編輯器也可加trigger發送確認信
- 新增表單
點選「新增/Google表單」

- 查看回應
表單的設計就不多說了,直接看回應
點選「查看回應」

- 編輯指令
點選「工具/指令碼編輯器」

- 新增Script檔案
點選「檔案/新增/指令碼檔案」

- 編輯Script

以下程式碼即為上圖的程式,參考以下改來的
reference: Send Google Forms by Email/* Send Confirmation Email with Google Forms */ function SendGoogleForm(e) { var message = ''; for (var filed in e.namedValues) { message += filed + ": " + e.namedValues[filed] + '< br />'; } var recipient = e.namedValues['電子信箱']; //e即為回覆的試算表,而namedValues即取得該欄位名的內容 var cc = 'yup.japan@gmail.com'; //cc一份給自己 var subject = "Yup!代購單確認單"; var sendername = 'Yup!代購'; var textbody = message.replace('< br />', '\n'); GmailApp.sendEmail(recipient, subject, textbody, {cc: cc, name: sendername, htmlBody: message}); } function Initialize() { var triggers = ScriptApp.getProjectTriggers(); for(var i in triggers) { ScriptApp.deleteTrigger(triggers[i]); } ScriptApp.newTrigger("SendGoogleForm") .forSpreadsheet(SpreadsheetApp.getActiveSpreadsheet()) .onFormSubmit() .create(); } - 啟動程序
寫好Script,現在還得設定觸發
點選「資源/現在專案的啟動程序」
 p.s. 如果仍收不到信的話 要先跑一次initialize(),手動執行or設觸發都可
- 新增觸發程序
由於尚未建立任何觸發程序,因此會跳出這個視窗
點選「尚未建立觸發程序,按一下....」

- 設定觸發程序
設定user提交表單時,才會觸發程序


這樣就完成了,user提交表單後,就會發信通知
p.s. 在google form及google試算表都可以寫script,但在form觸發會抓不到內容
p.p.s. 好像得先按「執行」run過一次程式裡的Initialize()
星期日, 7月 27, 2014
如何寫unit test
以前覺得unit test不就寫test case
想到啥,就寫啥,沒有目標的亂寫
記得以前連搬檔案都寫了一個case來測
最近領悟了點東西,趕緊來整理一下
大師也說... 不好寫的就不要刻意寫,工具有他的極限
不要硬寫,而搞死自己 <= 好吧 這句是我自己將來為了辯解沒寫unit test的藉口
想到啥,就寫啥,沒有目標的亂寫
記得以前連搬檔案都寫了一個case來測
最近領悟了點東西,趕緊來整理一下
- 測試資料
寫test case最麻煩的地方在準備測試資料
由於資料大多存取DB,因此得準備一個測試DB
但資料被改後,還得再倒回去,否則test case會fail
以前都用dump,再整個倒回去
開發上還挺累人的
個人測試還好,多人用同一個測試DB,就會互相蓋DB
難道要一人一DB嗎... 這提出申請,一定被上頭打槍...
後來才瞭解,這不是unit test
這已經是integration test(接DB)
unit test應該在幾秒內跑完才叫unit test
- 利用Mock & Stub模擬測試資料
後來就利用這做法,避免接DB,及外部API的動作
說方便... 是比接DB方便... 但也還好...還是得寫一堆code,只為了準備測試資料
想利用TDD寫好unit test,還是挺花時間的
要說服其他人用,力道上還是不夠 - 測邏輯就好
直到前陣子,Kent Beck, Martin Fowler及DHH在討論「 IS TDD DEAD 」
DHH在說實務上用TDD不可行,當然是被兩位大師訓了一頓...
不過影響最深刻的是Martin Fowler說他幾乎沒在寫Mock
實在太令人驚訝了...居然沒在寫mock.....
很想實際看一下些大師怎麼寫的...
雖然還是不知道大師怎麼寫的
不過自己重新領悟unit test就是在測試邏輯
即然是測邏輯.... 那.... 就把邏輯這段再抽成一個function獨立出來就容易測了
YA~~
現有終於可以輕鬆的寫test case (泣)
大師也說... 不好寫的就不要刻意寫,工具有他的極限
不要硬寫,而搞死自己 <= 好吧 這句是我自己將來為了辯解沒寫unit test的藉口
星期日, 7月 13, 2014
[書]敏捷與Scrum軟體開發速成
自己的team都是用XP開發
Scrum這詞也聽好幾年了,但一直不知道有何差異
聽完同事說的,還是掌握不到做法
有點見樹不見林的感覺
說完還是不知怎麼做
今天正好路過書店逛了一下
看到「敏捷與Scrum軟體開發速成」Amazon有4.5顆星的評價
嘖嘖~ 直接買來看
章節安排挺不錯,很順暢的一篇篇讀,也不會太多廢話,有些真的話很多...
從敏捷方法的緣起說起
再強調敏捷的價值觀與原則,不會硬套方法
最後帶入實務做法
感覺讀完就上手了~ 怪不得4.5顆星了~
近期來試一下...
翻譯也挺不錯的,用詞都很到味,可以感覺譯者懂這方面的domain knowledge
譯注也很用心在寫,第一次看過這麼多譯注
某些文化梗也有翻,而有些資料也得花時間找~
真是佛心來著~
星期五, 5月 23, 2014
程式應易抽換,而非再利用
幾年前看到這句話「程式應易抽換,而非再利用」,一直看不懂這意思
過去觀念一直是程式應模組化,以便「重覆使用」
怎麼會這麼說呢
最近在學軟體架構,講師又提到這詞
沒說沒感覺,再回去review Design Patterns
還真的都在說易更換,而非重覆使用
為什麼呢
先看這句Prefer composition over inheritance (組合超越繼承)
這句話也讓我想了很久
物件的好處不就是要繼承嗎?
怎麼又要我們不要用繼承,那過去在學的是什麼
原因1:父類別的改變就會直接影響所有的子類別
原因2:因為程式只會對父類別操作,所以子類別需熟悉父類的實作(例如父類別的function實作二件事,而子類別只實無一件事)
因此用composition不會影響原結構而且易於抽換不同的物件
所以"Prefer composition over inheritance"
而這句就代表了「程式應易抽換,而非再利用」
真是太深奧了...
星期四, 5月 08, 2014
DB 記憶體緩慢上升
最近DBA提到DB的記憶體有緩慢上升的問題
後來知道這是DB的機制,本來就會把記憶體吃滿
但DBA還是提出這樣他無法告之記憶體是否需擴充
針對這問題得看塞的內容是什麼
經過分析,我們的sql plan重複使用太低
也就是sql statement不重複,造成每次得重新compile新的sql
後來知道這是DB的機制,本來就會把記憶體吃滿
但DBA還是提出這樣他無法告之記憶體是否需擴充
針對這問題得看塞的內容是什麼
經過分析,我們的sql plan重複使用太低
也就是sql statement不重複,造成每次得重新compile新的sql
- 減少Compile次數
- 使用Stored Procedure
微軟建議SQL compile 不要超過 Batch Request的10%, 但我們的系統大約在40%
因此建議我們用Stored Procedure,當然我們沒用這方面 - 使用prepare(bind)
我本以為prepare只是用來過濾sql injection
原來db在執行時,也得把sql statement先compile過
因此where的條件不同,就會被當成新的statement
這時便可透過prepare,把參數給參數化 (我想不到更好的詞了 Orz)
如此一來該句只會被compile一次~
p.s. sql也是需被compile的,嗯... 我從沒想過這問題...
- PHP的PDO未實際改寫
我們早就用bind的方式寫sql,但不曉得為何仍沒有轉換
後來才發現原來PDO沒有實際轉換,而只是replace而已
p.s. 不確定是PDO or 其他地方,先拿PDO當替死鬼
- 使用Stored Procedure
星期一, 3月 03, 2014
tmux亂碼
把vi設定好後,本以為完成了
但有時正常,有時又亂碼,一直搞不懂
cli下的中文是「?????」
而vi下的會是「______________」
後來發現在進tmux後,才會發生這問題
查了一下,加上以下這段再重開tmux就可以了
vi ~/.bash_profile
Reference
tmux,亂碼已成往事
set encoding=utf-8
set fileencodings=utf-8,cp950,latin1
但有時正常,有時又亂碼,一直搞不懂
cli下的中文是「?????」
而vi下的會是「______________」
後來發現在進tmux後,才會發生這問題
查了一下,加上以下這段再重開tmux就可以了
vi ~/.bash_profile
export LANG="zh_TW.utf8"
export LC_ALL="zh_TW.utf8"
Reference
tmux,亂碼已成往事
星期四, 2月 20, 2014
MS SQL資料庫定序(Collation)的議題
問題
當兩個column join時,而兩個定序不同,這時這個sql session就直接死給你看
解決方法
解決方法
- 從db設定(但資料要重建)
db, column都可以指定 - sql query直接指定
SELECT str FROM test ORDER BY str COLLATE CHINESE_TAIWAN_STROKE_CI_AS
CS_AI vs CI_AS 傻傻搞不清楚
- CaseSensitive_AccentInsensitive
- CaseInsensitive_AccentSensitive
Reference
星期日, 2月 09, 2014
[書]even faster web sites performance-best practices for web developers

針對js, css, image, browser等深入探討,以求最佳的效能
Ch1. Understanding Ajax Performance
Trade-offs - Fast. Good. Cheap. Pick Two.

- 低於Inefficiency line就會流失user
- 先利用YSlow改善
- 利用ajax可大副降n,當然前提要考量ajax本體application要小
- 事後再抓資料呈現
- DOM及CSS的處理比JS的速度慢的多,針對JS加速不如小心處理DOM及CSS
Ch.2 Createing Responsive Web Applications
What is fast enough
- ajax實現快速反應系統
- 只針對不夠快的程式調整,重點是如何定義「不夠快」
- 0.1 second : Limit for users feeling that they are directly manipulating objects in the UI. 例如hover
- 1 second: Limit for users feeling that they are freely navigating the command space without having to unduly wait for the computer. 0.2秒~1秒會感覺在運作
- 10 seconds : Limit for users keeping their attention on the task.
- 也就是說application要在0.1s內啟動, 在1s內有所回應
- 超過1s會讓user感覺到慢, 超過10s.... 該調程式了...
Meausuring Latency
- 可利用firebug的profiler找出js的執行時間
- Threading - js沒有mutilthread,不要想有的沒的 這只會把程式搞複雜
- HTML5有Web Workers可達到threads效果,拿來當背景程式跑長時間的script
- 如果browser不支援,google有Gears plugin-in
Effects of Memory Use on Response Time
- memory也會造成效能issue
- 在run GC時,會run整個heap,回收不再使用的物件,因此大量使用下,會讓系統發生短暫凍結
- OS會提供virtual memory這比實體memory慢的多
- Troubleshooting Memory Issues
- 針js的memory沒有神器,只能追問題所在,參考 http://blog.pavlov.net/2008/03/11/firefox-3-memory-usage/
- Use the delete keyword to remove JavaScript objects that are no longer neededfrom memory.
ch.3 Splitting the Initial Payload
- 必要的application script先讀,不重要的後讀
- 不相關的script模組就不要讀
- 後讀的ui相關script要能先呈現loading圖示,避免user使用(lazy-loaded code)
- stub function
- 先回應空的,等載完後再覆寫
- splitting script & CSS都能達到效果
Ch4. Loading Scripts without Blocking
- 下載external script 會造成blocking(下載中的資源不會被擋)

ie8, Safari 4, Chrome 2可同時下載,但得等js載完且跑完,才會再下載其他資源
有方法可避開blocking的問題,但同時也有race conditions問題
即script如有順序問題,後者先執行會發生錯誤
解決方法
- XHR Eval
- 當資源下載後,用eval
- 缺點:需在同一domain
- XHR Injection
- 把js當dom方式插入
- 缺點:比eval慢
- Script in Iframe
- 開iframe把script當html下載
- 缺點:需在同一domain, iframe耗資源
- Script DOM Element
- 方法:create個dom,改src,簡單易懂
- var scriptElem = document.createElement('script');scriptElem.src = 'http://anydomain.com/A.js';document.getElementsByTagName('head')[0].appendChild(scriptElem);
- Script Defer
- 增加defer屬性,可平行下載
- 缺點:只有ie支援
- document.write Script Tag
- 類似defer,可平行下載
- 缺點:只有ie會平行下載
Ensuring (or Avoiding) Ordered Execution
利用script src寫法可確認依序下載

Ch.5 Coupling Asynchronous Scripts
Ch.6 Positioning Inline Scripts
Ch.7 Writing Efficient JavaScript
Managing Scope
Ch.8 Scaling with Comet
Ch.9 Going Beyond Gzipping
- Besides proper configuration of HTTP caching headers, enabling gzip compression is typically the most important technique for speeding up your web page
- 目前的browser都支援gzip,但會因firewall或防毒軟體限制而禁作gzip
- 針對這些可以有以下做法
- Design to Minimize Uncompressed Size
- Use Event Delegation (選完才載入)
- Use relative URLs
- 同網站內的uri可以用相對路徑,這樣文字相對少
- Strip whitespace
- Strip attirbute quotes
- html裡的attribute內容如為純文字(含括號,底線,分號等)可省略雙引號
- Avoid inline styling
- style多為重覆使用,寫在css共用
- Alias JavaScript
- Wasteful
- var foo = $("foo);
- foo.style.left = "0";
- foo.style.right = "0";
- Better
- var foo = $("foo).style;
- foo.left = "0";
- foo.right = "0";
- 以上約可節省11.7的傳輸量
Educate Users
- 發生user不支援Accept-Encoding,應給個訊息提供,教育user
- ex. Your Internet connection is slowed because it does not allow compression.
- 不過經過proxy來的是無法解決的
Fix this Hide
Ch.10 Optimizing Images
- GIF - 適用小動畫
- PNG - 適用圖表(graphics - icons, logos, diagrams)
- JPG - 適用照片(photos)
Truecolor versus palette image formats
Interlacing
Stripping JPEG Metadata
- Comments
- Application-specific (e.g., Photoshop) internal information
- EXIF information such as camera make and model, the date the photo was taken, the geolocation of the photo, thumbnails, or even audio
Ch.11 Sharding Dominant Domains
Ch.12 Flushing the Document Early
Ch.13 Using Iframes Sparingly
Ch.14 Simplifying CSS Selectors
- 將css置於head中,以提高progressive rendering. (See High Performance Web Sites, Chapter 5.)
- ie可能發生css expression被執行上千次
- 避免inline styling,以減少download size
CSS Selectors有以下幾種方式
- ID SelectorsExample: #toc { margin-left: 20px; }Simple and efficient
- Class SelectorsExample: .chapter { font-weight: bold; }
- Type SelectorsExample: A { text-decoration: none; }a lightweight way to add styling to all elements of a specified type, without having to add any extra characters
- Adjacent Sibling SelectorsExample: H1 + #toc { margin-top: 40px; }
- Child SelectorsExample: #toc > LI { font-weight: bold; }找出#toc下所有的LI(1層)
- Descendant SelectorsExample: #toc A { color: #444; }找出#toc下所有的A(n層)
- Universal SelectorsExample: * { font-family: Arial; }
- Attribute SelectorsExample: [href="#index"] { font-style: italic; }
- Pseudo-Classes and Pseudo-ElementsExample: A:hover { text-decoration: underline
以下討論performace
Rightmost First
Consider the following rule:
#toc > LI { font-weight: bold; }
由於id最有效,因此大家會認為先找#toc,再找底下的LI是較好的方法(左到右)
但其實browser是從右到左,因此這段selector反而相當沒效率,但先找出所有的LI,再看他的parent是不是#toc
可以想見Descendant Selectors就更差了,所有的node除非找到#toc,否則都要走完
Writing Efficient CSS Selectors
- Avoid universal rules
In addition to the traditional definition of universal selectors, Hyatt lumps adjacentsibling selectors, child selectors, descendant selectors, and attribute selectors intothis category of “universal rules.” He recommends using ID, class, and tag selectorsexclusively. - Don’t qualify ID selectors
Because there is only one element in the page with a given ID, there’s no need toadd additional qualifiers. For example, DIV #toc is unnecessary and should be
simplified to #toc. - Don’t qualify class selectorsInstead of qualifying class selectors for specific tags, extend the class name to be specific to the use case. For example, change LI .chapter to .li-chapter , or better yet, .list-chapter.
- Make rules as specific as possibleDon’t be tempted to build long selectors, such as OL LI A. It’s better to create a class, such as .list-anchor, and add it to the appropriate elements.
- Avoid descendant selectorsDescendant selectors are typically the most expensive to process. Child selectors are often what’s intended and can be more efficient. It’s even better to follow the next guideline to avoid child selectors as well.
- Avoid tag-child selectorsIf you have a child selector that is based on a tag, such as #toc > LI > A, use a class associated with each of those tag elements, such as .toc-anchor.
- Question all usages of the child selectorThis is another reminder to review all places where child selectors are used, and replace them with specific classes when possible.
- Rely on inheritanceLearn which properties are inherited, and avoid rules that specify these inherited styles. For example, specify list-style-image on the list element instead of on eachlist item element. Consult the list
星期六, 1月 18, 2014
利用git管理production及development程式
個人開發可利用branch避免開發中的code影響緊急bug修正的問題
不過在團隊開發下,不曉得怎麼區分管理
看了網路上的建議,自己簡化為
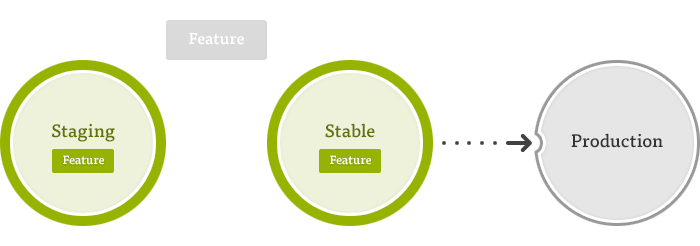
建立production branch
1.開發用master
2.緊急上版用production修bug

另外...
由於公司內規定得透過包版上patch
而公司用CCCQ管理包版,因此每次都得再重上程式
這辦法也解決每次上patch都不確認是否有包到這次異動的檔案
看production merge後異動的檔案,即為patch內容
真是太棒了
不過
其實作者是建議切成staging, development, production三個
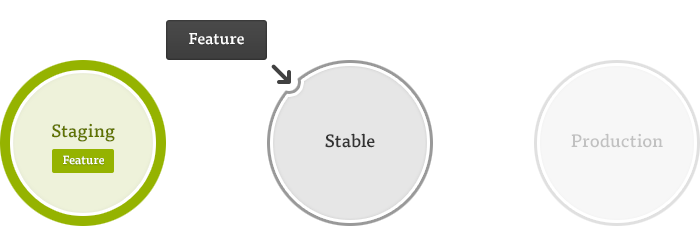
前者可拿來驗證後才准入後者
但是上測試機一樣得進CCCQ,才能包版更新... 所以就沒考慮了
反正開發機試完,只能進CCCQ上測試機...

Reference
Developing and Deploying with Branches
不過在團隊開發下,不曉得怎麼區分管理
看了網路上的建議,自己簡化為
建立production branch
1.開發用master
2.緊急上版用production修bug
另外...
由於公司內規定得透過包版上patch
而公司用CCCQ管理包版,因此每次都得再重上程式
這辦法也解決每次上patch都不確認是否有包到這次異動的檔案
看production merge後異動的檔案,即為patch內容
真是太棒了
不過
其實作者是建議切成staging, development, production三個
前者可拿來驗證後才准入後者
但是上測試機一樣得進CCCQ,才能包版更新... 所以就沒考慮了
反正開發機試完,只能進CCCQ上測試機...
Reference
Developing and Deploying with Branches
星期六, 12月 21, 2013
Loading Scripts Without Blocking
最近同事發現有隻script會block其他request
查了一下原來script還真有這問題
在「Even Fast Web Sites」有提到
可以實際試一下
http://stevesouders.com/cuzillion/?ex=10008&title=Scripts+Block+Downloads

作者的說明是...
中文就是指...
可以看出兩個script會等待,且會block其他requests下載
兩段的空白是script執行時間,完成後才會進行下一步
二個scripts都好了,才會再同時download其他resources
解決方法
作者有提出幾種方法,不過似乎都不能一次解決
書是2009年出的,想說有沒有新的解決方法,google看到了這段
reference: What is a non-blocking script?
特別是處理UI的javascript(UI沒反應or掛了)
因為以上的方法只要下載完就會執行,不管在html裡的順序
ie可設定defer屬性使script同時下載,並依序執行
「Even Fast Web Sites」的作者有建議
後讀的ui相關script要能先呈現loading圖示,避免user使用(lazy-loaded code)
或者可做stub function,先回應空的,等載完後再覆寫
查了一下原來script還真有這問題
在「Even Fast Web Sites」有提到
SCRIPT tags have a negative impact on page performance because of their blocking
behavior. While scripts are being downloaded and executed, most browsers won’t
download anything else. There are times when it’s necessary to have this blocking, but
it’s important to identify situations when JavaScript can be loaded independent of the
rest of the page.
可以實際試一下
http://stevesouders.com/cuzillion/?ex=10008&title=Scripts+Block+Downloads

作者的說明是...
This page has two scripts at the top, A.js and B.js, followed by an image, a stylesheet, and an iframe. The scripts are each programmed to take one second to download and one second to execute. The white gaps in the HTTP profile indicate where the scripts are executed. This shows that while scripts are being downloaded and executed, all other downloads are blocked. Only after the scripts have finished are the image, stylesheet, and iframe merrily downloaded in parallel.
中文就是指...
可以看出兩個script會等待,且會block其他requests下載
兩段的空白是script執行時間,完成後才會進行下一步
二個scripts都好了,才會再同時download其他resources
解決方法
作者有提出幾種方法,不過似乎都不能一次解決
書是2009年出的,想說有沒有新的解決方法,google看到了這段
reference: What is a non-blocking script?
- create a script node dynamically and
var scriptElem = document.createElement('script');| scriptElem.src = 'http://anydomain.com/A.js'; document.getElementsByTagName('head')[0].appendChild(scriptElem); - use the HTML5 async attribute of a <script> tag.
# 我是註解
<script type="text/javascript" async src="foo.js"> </script>
特別是處理UI的javascript(UI沒反應or掛了)
因為以上的方法只要下載完就會執行,不管在html裡的順序
ie可設定defer屬性使script同時下載,並依序執行
「Even Fast Web Sites」的作者有建議
後讀的ui相關script要能先呈現loading圖示,避免user使用(lazy-loaded code)
或者可做stub function,先回應空的,等載完後再覆寫
星期四, 11月 28, 2013
db 的index有這麼多搞頭
最近系統流量大,在db遇到些瓶頸
經過dba分析,對index也有比較深入的瞭解
還挺了滿多觀念的,一時還無法全吸收
再慢慢整理了
經過dba分析,對index也有比較深入的瞭解
- index不只index
以前說設index,就只知道較常查詢的欄位拿來設為index就好了
經dba細心分析,才知道除了設定外,連多個欄位組合的index前後的順序也有差
較常查詢的欄位要放前面 - select除了設index外,還可以...
可以針對sql語句,帶出指定的select column,也可以指定where的column - insert, update也可以設定index
- cluster index & noncluster index
看不懂這東西,經dba解釋
cluster index會將同table的其他欄位一起帶出
所以cluster index只會有一個
反之nocluster不會,不過就可以彈性的指定必要的欄位 東西帶的少了,搜尋效率自然提升
- no lock
可以dirty read的select就加no lock(mssql)吧
避免waiting - db的原生函式會造成full table scan
本想說先在sql的where句做了一些轉型,這樣比較好過濾
但dba提出這造成full table scan,效能很差
改完後,這top sql(slow log)就不見了 - 用變數存GETDATE
條件式或異動欄位常用到GETDATE(),有隻SQL用到5次
DBA建議先存變數裡,這樣compile 1次,也只跑1次
還挺了滿多觀念的,一時還無法全吸收
再慢慢整理了
linux複製資料,並排除指定資料夾
要複製資料夾很容易,不過要排除某個資料夾就不知怎麼做了
最近需手動複製git資料夾,複製.git太多太久,所以想拿掉
查了一下只要這麼下就可以了
rsync -av --progress sourcDir tmp --exclude srouceDir/.git
說明:複製sourceDir 到tmp底下,要排除sourceDir/.git這資料夾
最近需手動複製git資料夾,複製.git太多太久,所以想拿掉
查了一下只要這麼下就可以了
rsync -av --progress sourcDir tmp --exclude srouceDir/.git
說明:複製sourceDir 到tmp底下,要排除sourceDir/.git這資料夾
星期日, 10月 27, 2013
拿GUIDs當Primary Key
最近維護個專案,發現是拿GUID當做DB的Primary Key用,同事還說最近大家都這麼用...
一直想不到好處在哪,只好上網看看評論- 主要還是建議用integer做pk
因為用integer做auto increment達到不重覆有額外的優點
- 連續,在排序上能做到partial scan,不會用到table scan讓搜尋效能較好這點我是不瞭解,平常的專案可能沒什麼問題不過最近幾個project是電子商務,常遇到效能的issue發現有table scan的sql statment都會被吊起打不過後來有問"專業"的DBA他說pk都有index啦,誰管他連不連續... 這... Orz
- guid的index資料較大
在搜尋上,也會因guid比integer大多了,要比對更大的資料(25MB vs 106MB) - 讓別人看不出銷售情況
例如訂單編號如果很單純(天真?)的利用流水號給客戶使用
容易被人看出最近的銷售狀況
所以...
目前看的好處是分散式的DB好運作
也有同事提出如果常有table需合併時,就很適合guid
所以還是得評估自己需要的solution
以下截錄,推薦的三篇po文也滿精采的 可以看一下
Ref: Identity Column as Primary Key
Yes, using a INT (or BIGINT) IDENTITY is very good practice for SQL Server.
SQL Server uses the primary key as its default clustering key, and the clustering key should always have these properties:
- narrow
- static
- unique
INT IDENTITY fits the bill perfectly!
- ever-increasing
For more background info, and especially some info why a GUID as your primary (and thus clustering key) is a bad idea, see Kimberly Tripp's excellent posts:
If you have reasons to use a GUID as primary key (e.g. replication), then by all means make sure to have a INT IDENTITY as your clustering key on those tables!
Marc
星期六, 10月 26, 2013
轉:Memcached 集群架構方面的問題
Reference Memcached 集群架構方面的問題
集群架構方面的問題
o memcached是怎麼工作的?
o memcached最大的優勢是什麼?
o memcached和MySQL的query cache相比,有什麼優缺點?
o memcached和服務器的local cache(比如PHP的APC、mmap文件等)相比,有什麼優缺點?
o memcached的cache機制是怎樣的?
o memcached如何實現冗餘機制?
o memcached如何處理容錯的?
o 如何將memcached中item批量導入導出?
o 但是我確實需要把memcached中的item都dump出來,確實需要把數據load到memcached中,怎麼辦?
o memcached是如何做身份驗證的?
o 如何使用memcached的多線程是什麼?如何使用它們?
o memcached能接受的key的最大長度是多少?(250bytes)
o memcached對item的過期時間有什麼限制?(為什麼有30天的限制?)
o memcached最大能存儲多大的單個item?(1M byte)
o 為什麼單個item的大小被限制在1M byte之內?
o 為了讓memcached更有效地使用服務器的內存,可以在各個服務器上配置大小不等的緩存空間嗎?
o 什麼是binary協議?它值得關注嗎?
o memcached是如何分配內存的?為什麼不用malloc/free!?究竟為什麼使用slab呢?
o memcached能保證數據存儲的原子性嗎?
集群架構方面的問題
memcached是怎麼工作的?
Memcached的神奇來自兩階段哈希(two-stage hash)。Memcached就像一個巨大的、存儲了很多對的哈希表。通過key,可以存儲或查詢任意的數據。
客戶端可以把數據存儲在多台memcached上。當查詢數據時,客戶端首先參考節點列表計算出key的哈希值(階段一哈希),進而選中一個節點;客戶端將請求發送給選中的節點,然後memcached節點通過一個內部的哈希算法(階段二哈希),查找真正的數據(item)。
舉個列子,假設有3個客戶端1, 2, 3,3台memcached A, B, C:
Client 1想把數據”barbaz”以key “foo”存儲。Client 1首先參考節點列表(A, B, C),計算key “foo”的哈希值,假設memcached B被選中。接著,Client 1直接connect到memcached B,通過key “foo”把數據”barbaz”存儲進去。Client 2使用與Client 1相同的客戶端庫(意味著階段一的哈希算法相同),也擁有同樣的memcached列表(A, B, C)。
於是,經過相同的哈希計算(階段一),Client 2計算出key “foo”在memcached B上,然後它直接請求memcached B,得到數據”barbaz”。
各種客戶端在memcached中數據的存儲形式是不同的(perl Storable, php serialize, java hibernate, JSON等)。一些客戶端實現的哈希算法也不一樣。但是,memcached服務器端的行為總是一致的。
最後,從實現的角度看,memcached是一個非阻塞的、基於事件的服務器程序。這種架構可以很好地解決C10K problem ,並具有極佳的可擴展性。
可以參考A Story of Caching ,這篇文章簡單解釋了客戶端與memcached是如何交互的。
memcached最大的優勢是什麼?
請仔細閱讀上面的問題(即memcached是如何工作的)。Memcached最大的好處就是它帶來了極佳的水平可擴展性,特別是在一個巨大的系統中。由於客戶端自己做了一次哈希,那麼我們很容易增加大量memcached到集群中。memcached之間沒有相互通信,因此不會增加memcached的負載;沒有多播協議,不會網絡通信量爆炸(implode)。memcached的集群很好用。內存不夠了?增加幾台memcached吧;CPU不夠用了?再增加幾台吧;有多餘的內存?在增加幾台吧,不要浪費了。
基於memcached的基本原則,可以相當輕鬆地構建出不同類型的緩存架構。除了這篇FAQ,在其他地方很容易找到詳細資料的。
看看下面的幾個問題吧,它們在memcached、服務器的local cache和MySQL的query cache之間做了比較。這幾個問題會讓您有更全面的認識。
memcached和MySQL的query cache相比,有什麼優缺點?
把memcached引入應用中,還是需要不少工作量的。MySQL有個使用方便的query cache,可以自動地緩存SQL查詢的結果,被緩存的SQL查詢可以被反复地快速執行。Memcached與之相比,怎麼樣呢?MySQL的query cache是集中式的,連接到該query cache的MySQL服務器都會受益。
* 當您修改表時,MySQL的query cache會立刻被刷新(flush)。存儲一個memcached item只需要很少的時間,但是當寫操作很頻繁時,MySQL的query cache會經常讓所有緩存數據都失效。
* 在多核CPU上,MySQL的query cache會遇到擴展問題(scalability issues)。在多核CPU上,query cache會增加一個全局鎖(global lock), 由於需要刷新更多的緩存數據,速度會變得更慢。
* 在MySQL的query cache中,我們是不能存儲任意的數據的(只能是SQL查詢結果)。而利用memcached,我們可以搭建出各種高效的緩存。比如,可以執行多個獨立的查詢,構建出一個用戶對象(user object),然後將用戶對象緩存到memcached中。而query cache是SQL語句級別的,不可能做到這一點。在小的網站中,query cache會有所幫助,但隨著網站規模的增加,query cache的弊將大於利。
* query cache能夠利用的內存容量受到MySQL服務器空閒內存空間的限制。給數據庫服務器增加更多的內存來緩存數據,固然是很好的。但是,有了memcached,只要您有空閒的內存,都可以用來增加memcached集群的規模,然後您就可以緩存更多的數據。
memcached和服務器的local cache(比如PHP的APC、mmap文件等)相比,有什麼優缺點?
首先,local cache有許多與上面(query cache)相同的問題。local cache能夠利用的內存容量受到(單台)服務器空閒內存空間的限制。不過,local cache有一點比memcached和query cache都要好,那就是它不但可以存儲任意的數據,而且沒有網絡存取的延遲。
* local cache的數據查詢更快。考慮把highly common的數據放在local cache中吧。如果每個頁面都需要加載一些數量較少的數據,考慮把它們放在local cached吧。
* local cache缺少集體失效(group invalidation)的特性。在memcached集群中,刪除或更新一個key會讓所有的觀察者覺察到。但是在local cache中, 我們只能通知所有的服務器刷新cache(很慢,不具擴展性),或者僅僅依賴緩存超時失效機制。
* local cache面臨著嚴重的內存限制,這一點上面已經提到。
memcached的cache機制是怎樣的?
Memcached 主要的cache機制是LRU(最近最少用)算法+超時失效。當您存數據到memcached中,可以指定該數據在緩存中可以呆多久Which is forever, or some time in the future。如果memcached的內存不夠用了,過期的slabs會優先被替換,接著就輪到最老的未被使用的slabs。
memcached如何實現冗餘機制?
不實現!我們對這個問題感到很驚訝。Memcached應該是應用的緩存層。它的設計本身就不帶有任何冗餘機制。如果一個memcached節點失去了所有數據,您應該可以從數據源(比如數據庫)再次獲取到數據。您應該特別注意,您的應用應該可以容忍節點的失效。不要寫一些糟糕的查詢代碼,寄希望於memcached來保證一切!如果您擔心節點失效會大大加重數據庫的負擔,那麼您可以採取一些辦法。比如您可以增加更多的節點(來減少丟失一個節點的影響),熱備節點(在其他節點down了的時候接管IP),等等。
memcached如何處理容錯的?
不處理!:) 在memcached節點失效的情況下,集群沒有必要做任何容錯處理。如果發生了節點失效,應對的措施完全取決於用戶。節點失效時,下面列出幾種方案供您選擇:
* 忽略它! 在失效節點被恢復或替換之前,還有很多其他節點可以應對節點失效帶來的影響。
* 把失效的節點從節點列表中移除。做這個操作千萬要小心!在默認情況下(餘數式哈希算法),客戶端添加或移除節點,會導致所有的緩存數據不可用!因為哈希參照的節點列表變化了,大部分key會因為哈希值的改變而被映射到(與原來)不同的節點上。
* 啟動熱備節點,接管失效節點所佔用的IP。這樣可以防止哈希紊亂(hashing chaos)。
* 如果希望添加和移除節點,而不影響原先的哈希結果,可以使用一致性哈希算法(consistent hashing)。您可以百度一下一致性哈希算法。支持一致性哈希的客戶端已經很成熟,而且被廣泛使用。去嘗試一下吧!
* 兩次哈希(reshing)。當客戶端存取數據時,如果發現一個節點down了,就再做一次哈希(哈希算法與前一次不同),重新選擇另一個節點(需要注意的時,客戶端並沒有把down的節點從節點列表中移除,下次還是有可能先哈希到它)。如果某個節點時好時壞,兩次哈希的方法就有風險了,好的節點和壞的節點上都可能存在臟數據(stale data)。
如何將memcached中item批量導入導出?
您不應該這樣做!Memcached是一個非阻塞的服務器。任何可能導致memcached暫停或瞬時拒絕服務的操作都應該值得深思熟慮。向memcached中批量導入數據往往不是您真正想要的!想像看,如果緩存數據在導出導入之間發生了變化,您就需要處理臟數據了;如果緩存數據在導出導入之間過期了,您又怎麼處理這些數據呢?
因此,批量導出導入數據並不像您想像中的那麼有用。不過在一個場景倒是很有用。如果您有大量的從不變化的數據,並且希望緩存很快熱(warm)起來,批量導入緩存數據是很有幫助的。雖然這個場景並不典型,但卻經常發生,因此我們會考慮在將來實現批量導出導入的功能。
Steven Grimm,一如既往地,,在郵件列表中給出了另一個很好的例子:http://lists.danga.com/pipermail/memcached/2007-July/004802.html 。
但是我確實需要把memcached中的item批量導出導入,怎麼辦??
好吧好吧。如果您需要批量導出導入,最可能的原因一般是重新生成緩存數據需要消耗很長的時間,或者數據庫壞了讓您飽受痛苦。
如果一個memcached節點down了讓您很痛苦,那麼您還會陷入其他很多麻煩。您的系統太脆弱了。您需要做一些優化工作。比如處理”驚群”問題(比如memcached節點都失效了,反复的查詢讓您的數據庫不堪重負…這個問題在FAQ的其他提到過),或者優化不好的查詢。記住,Memcached 並不是您逃避優化查詢的藉口。
如果您的麻煩僅僅是重新生成緩存數據需要消耗很長時間(15秒到超過5分鐘),您可以考慮重新使用數據庫。這裡給出一些提示:
* 使用MogileFS(或者CouchDB等類似的軟件)在存儲item。把item計算出來並dump到磁盤上。MogileFS可以很方便地覆寫item,並提供快速地訪問。.您甚至可以把MogileFS中的item緩存在memcached中,這樣可以加快讀取速度。MogileFS+Memcached的組合可以加快緩存不命中時的響應速度,提高網站的可用性。
* 重新使用MySQL。MySQL的InnoDB主鍵查詢的速度非常快。如果大部分緩存數據都可以放到VARCHAR字段中,那麼主鍵查詢的性能將更好。從memcached中按key查詢幾乎等價於MySQL的主鍵查詢:將key 哈希到64-bit的整數,然後將數據存儲到MySQL中。您可以把原始(不做哈希)的key存儲都普通的字段中,然後建立二級索引來加快查詢…key被動地失效,批量刪除失效的key,等等。
上面的方法都可以引入memcached,在重啟memcached的時候仍然提供很好的性能。由於您不需要當心”hot”的item被memcached LRU算法突然淘汰,用戶再也不用花幾分鐘來等待重新生成緩存數據(當緩存數據突然從內存中消失時),因此上面的方法可以全面提高性能。
關於這些方法的細節,詳見博客:http://dormando.livejournal.com/495593.html 。
memcached是如何做身份驗證的?
沒有身份認證機制!memcached是運行在應用下層的軟件(身份驗證應該是應用上層的職責)。memcached的客戶端和服務器端之所以是輕量級的,部分原因就是完全沒有實現身份驗證機制。這樣,memcached可以很快地創建新連接,服務器端也無需任何配置。
如果您希望限制訪問,您可以使用防火牆,或者讓memcached監聽unix domain socket。
memcached的多線程是什麼?如何使用它們?
線程就是定律(threads rule)!在Steven Grimm和Facebook的努力下,memcached 1.2及更高版本擁有了多線程模式。多線程模式允許memcached能夠充分利用多個CPU,並在CPU之間共享所有的緩存數據。memcached使用一種簡單的鎖機制來保證數據更新操作的互斥。相比在同一個物理機器上運行多個memcached實例,這種方式能夠更有效地處理multi gets。
如果您的系統負載並不重,也許您不需要啟用多線程工作模式。如果您在運行一個擁有大規模硬件的、龐大的網站,您將會看到多線程的好處。
更多信息請參見:http://code.sixapart.com/svn/memcached/trunk/server/doc/threads.txt 。
簡單地總結一下:命令解析(memcached在這里花了大部分時間)可以運行在多線程模式下。memcached內部對數據的操作是基於很多全局鎖的(因此這部分工作不是多線程的)。未來對多線程模式的改進,將移除大量的全局鎖,提高memcached在負載極高的場景下的性能。
memcached能接受的key的最大長度是多少?
key 的最大長度是250個字符。需要注意的是,250是memcached服務器端內部的限制,如果您使用的客戶端支持”key的前綴”或類似特性,那麼key(前綴+原始key)的最大長度是可以超過250個字符的。我們推薦使用使用較短的key,因為可以節省內存和帶寬。
memcached對item的過期時間有什麼限制?
過期時間最大可以達到30天。memcached把傳入的過期時間(時間段)解釋成時間點後,一旦到了這個時間點,memcached就把item置為失效狀態。這是一個簡單但obscure的機制。
memcached最大能存儲多大的單個item?
1MB。如果你的數據大於1MB,可以考慮在客戶端壓縮或拆分到多個key中。
為什麼單個item的大小被限制在1M byte之內?
啊…這是一個大家經常問的問題!
簡單的回答:因為內存分配器的算法就是這樣的。
詳細的回答:Memcached的內存存儲引擎(引擎將來可插拔…),使用slabs來管理內存。內存被分成大小不等的slabs chunks(先分成大小相等的slabs,然後每個slab被分成大小相等chunks,不同slab的chunk大小是不相等的)。chunk的大小依次從一個最小數開始,按某個因子增長,直到達到最大的可能值。
如果最小值為400B,最大值是1MB,因子是1.20,各個slab的chunk的大小依次是:slab1 - 400B slab2 - 480B slab3 - 576B …
slab中chunk越大,它和前面的slab之間的間隙就越大。因此,最大值越大,內存利用率越低。Memcached必須為每個slab預先分配內存,因此如果設置了較小的因子和較大的最大值,會需要更多的內存。
還有其他原因使得您不要這樣向memcached中存取很大的數據…不要嘗試把巨大的網頁放到mencached中。把這樣大的數據結構load和unpack到內存中需要花費很長的時間,從而導致您的網站性能反而不好。
如果您確實需要存儲大於1MB的數據,你可以修改slabs.c:POWER_BLOCK的值,然後重新編譯memcached;或者使用低效的malloc/free。其他的建議包括數據庫、MogileFS等。
我可以在不同的memcached節點上使用大小不等的緩存空間嗎?這麼做之後,memcached能夠更有效地使用內存嗎?
Memcache 客戶端僅根據哈希算法來決定將某個key存儲在哪個節點上,而不考慮節點的內存大小。因此,您可以在不同的節點上使用大小不等的緩存。但是一般都是這樣做的:擁有較多內存的節點上可以運行多個memcached實例,每個實例使用的內存跟其他節點上的實例相同。
什麼是二進制協議,我該關注嗎?
關於二進制最好的信息當然是二進制協議規範:http://code.google.com/p/memcached/wiki/MemcacheBinaryProtocol 。
二進制協議嘗試為端提供一個更有效的、可靠的協議,減少客戶端/服務器端因處理協議而產生的CPU時間。
根據Facebook的測試,解析ASCII協議是memcached中消耗CPU時間最多的環節。所以,我們為什麼不改進ASCII協議呢?
在這個郵件列表的thread中可以找到一些舊的信息:http://lists.danga.com/pipermail/memcached/2007-July/004636.html 。
memcached的內存分配器是如何工作的?為什麼不適用malloc/free!?為何要使用slabs?
實際上,這是一個編譯時選項。默認會使用內部的slab分配器。您確實確實應該使用內建的slab分配器。最早的時候,memcached只使用malloc/free來管理內存。然而,這種方式不能與OS的內存管理以前很好地工作。反复地malloc/free造成了內存碎片,OS最終花費大量的時間去查找連續的內存塊來滿足malloc的請求,而不是運行memcached進程。如果您不同意,當然可以使用malloc!只是不要在郵件列表中抱怨啊:)
slab分配器就是為了解決這個問題而生的。內存被分配並劃分成chunks,一直被重複使用。因為內存被劃分成大小不等的slabs,如果item的大小與被選擇存放它的slab不是很合適的話,就會浪費一些內存。Steven Grimm正在這方面已經做出了有效的改進。
郵件列表中有一些關於slab的改進(power of n 還是power of 2)和權衡方案:http://lists.danga.com/pipermail/memcached/2006-May/002163.html http://lists.danga .com/pipermail/memcached/2007-March/003753.html 。
如果您想使用malloc/free,看看它們工作地怎麼樣,您可以在構建過程中定義USE_SYSTEM_MALLOC。這個特性沒有經過很好的測試,所以太不可能得到開發者的支持。
更多信息:http://code.sixapart.com/svn/memcached/trunk/server/doc/memory_management.txt 。
memcached是原子的嗎?
當然!好吧,讓我們來明確一下:
所有的被發送到memcached的單個命令是完全原子的。如果您針對同一份數據同時發送了一個set命令和一個get命令,它們不會影響對方。它們將被串行化、先後執行。即使在多線程模式,所有的命令都是原子的,除非程序有bug:)
命令序列不是原子的。如果您通過get命令獲取了一個item,修改了它,然後想把它set回memcached,我們不保證這個item沒有被其他進程(process,未必是操作系統中的進程)操作過。在並發的情況下,您也可能覆寫了一個被其他進程set的item。
memcached 1.2.5以及更高版本,提供了gets和cas命令,它們可以解決上面的問題。如果您使用gets命令查詢某個key的item,memcached會給您返回該item當前值的唯一標識。如果您覆寫了這個item並想把它寫回到memcached中,您可以通過cas命令把那個唯一標識一起發送給memcached。如果該item存放在memcached中的唯一標識與您提供的一致,您的寫操作將會成功。如果另一個進程在這期間也修改了這個item,那麼該item存放在memcached中的唯一標識將會改變,您的寫操作就會失敗。
通常,基於memcached中item的值來修改item,是一件棘手的事情。除非您很清楚自己在做什麼,否則。
Memcached的應用
作者:Lightning@小寶發佈時間:November 2, 2009 分類:互聯網系統架構
Memcached是高性能的,分佈式的內存對象緩存系統,用於在動態應用中減少數據庫負載,提升訪問速度。Memcached由Danga Interactive(運營LiveJournal的技術團隊)開發,用於提升LiveJournal.com訪問速度的。LJ每秒動態頁面訪問量是幾千次,用戶700萬。Memcached將數據負載大幅度降低,更好的分配資源,更快速訪問。
其實Memcache是這個項目的名稱,而memcached是它服務器端的主程序文件名
Memcached可以應對任意多個連接,使用非阻塞的網絡IO。由於它的工作機制是在內存中開闢一塊空間,然後建立一個HashTable,Memcached自管理這些HashTable.
雖然memcached使用了同樣的“Key=>Value”方式組織數據,但是它和共享內存、APC等本地緩存有非常大的區別。Memcached是分佈式的,也就是說它不是本地的。它基於網絡連接(當然它也可以使用localhost)方式完成服務,本身它是一個獨立於應用的程序或守護進程(Daemon方式)。
Memcached最吸引人的一個特性就是支持分佈式部署;也就是說可以在一群機器上建立一堆Memcached 服務,每個服務可以根據具體服務器的硬件配置使用不同大小的內存塊,這樣一來,理論上可以建立一個無限巨大的基於內存的cache storage 系統。
Memcached使用libevent庫實現網絡連接服務,理論上可以處理無限多的連接,但是它和Apache不同,它更多的時候是面向穩定的持續連接的,所以它實際的並發能力是有限制的。在保守情況下memcached的最大同時連接數為200,這和Linux線程能力有關係,這個數值是可以調整的。關於libevent可以參考相關文檔。Memcached內存使用方式也和APC不同。APC是基於共享內存和MMAP的,memcachd有自己的內存分配算法和管理方式,它和共享內存沒有關係,也沒有共享內存的限制,通常情況下,每個memcached進程可以管理2GB的內存空間,如果需要更多的空間,可以增加進程數。
Memcached在很多時候都是作為數據庫前端cache使用的。因為它比數據庫少了很多SQL解析、磁盤操作等開銷,而且它是使用內存來管理數據的, 所以它可以提供比直接讀取數據庫更好的性能,在大型系統中,訪問同樣的數據是很頻繁的,memcached可以大大降低數據庫壓力,使系統執行效率提升。另外,memcached也經常作為服務器之間數據共享的存儲媒介,例如在SSO系統中保存系統單點登陸狀態的數據就可以保存在memcached中,被多個應用共享。
需要注意的是,使用Memcache的網站一般流量都是比較大的,為了緩解數據庫的壓力,讓Memcache作為一個緩存區域,把部分信息保存在內存中, 在前端能夠迅速的進行存取。由於memcached使用內存管理數據,所以它是易失的,當服務器重啟,或者memcached進程中止,數據便會丟失,所以memcached不能用來持久保存數據。很多人的錯誤理解,memcached的性能非常好,好到了內存和硬盤的對比程度,其實memcached使用內存並不會得到成百上千的讀寫速度提高,它的實際瓶頸在於網絡連接,它和使用磁盤的數據庫系統相比,好處在於它本身非常“輕”,因為沒有過多的開銷和直接的讀寫方式,它可以輕鬆應付非常大的數據交換量,所以經常會出現兩條千兆網絡帶寬都滿負荷了,memcached進程本身並不佔用多少CPU資源的情況。
Memcached是“分佈式”的內存對象緩存系統,所以那些不需要“分佈”的,不需要共享的,或者乾脆規模小到只有一台服務器的應用,memcached不會帶來任何好處,相反還會拖慢系統效率,因為網絡連接同樣需要資源,即使是UNIX本地連接也一樣。
訂閱:
文章 (Atom)